AI 회사의 매출이 얼마라는 말도, 생명과학에 큰돈이 들어온다는 발표도 처음 들으면 분명해 보인다. 하지만 무엇을 합산했는지 읽고 나면 숫자의 뜻이 달라진다. 관련 있는 설명서를 붙이면 AI가 더 잘할 것이라는 기대 역시 실제 시험에서는 늘 맞지 않았다. 10월 9일 아침까지 나온 소식은 그럴듯한 첫인상에서 한 걸음 더 들어가 볼 이유를 보여 준다.
오픈AI 매출의 두 숫자에는 서로 다른 몫이 들어 있었다
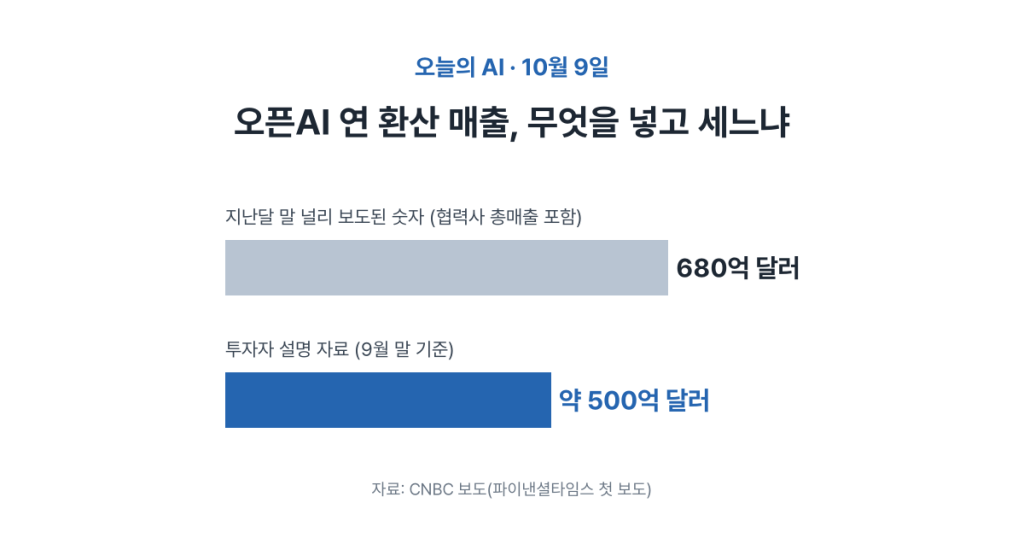
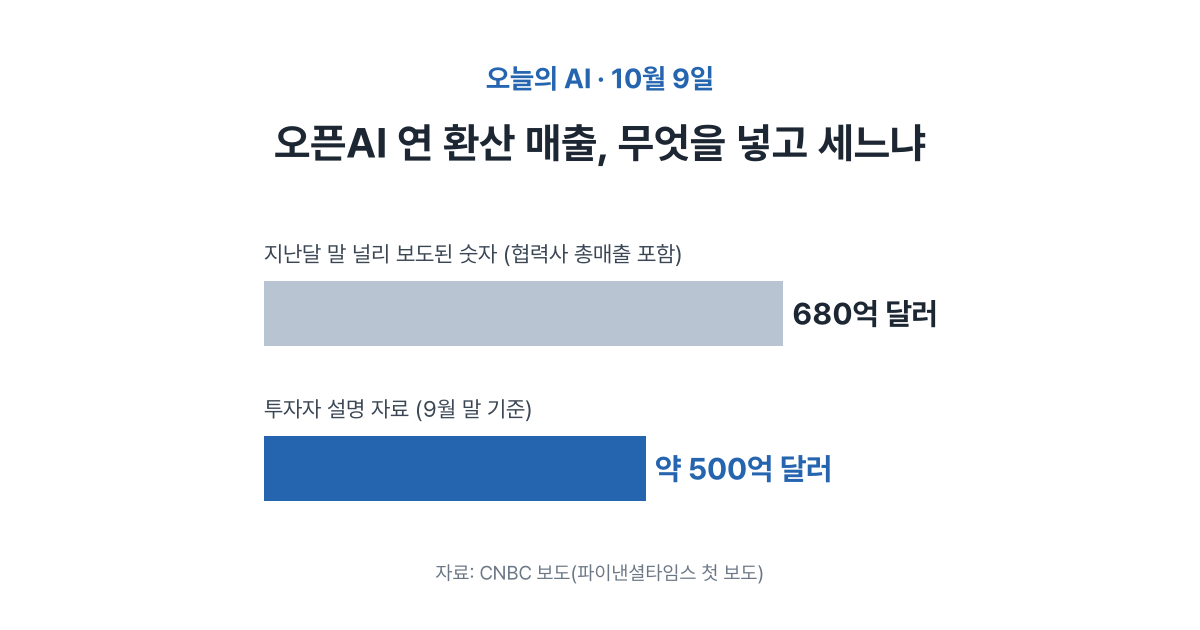
CNBC는 오픈AI가 투자자 설명 자료에서 9월 말 기준 연 환산 매출을 약 500억 달러라고 밝혔다고 확인 보도했다. 파이낸셜타임스가 먼저 전한 숫자다. 지난달 말 널리 퍼진 680억 달러와 차이가 나는 이유에 대해 CNBC가 인용한 관계자는 협력사들이 거둔 총매출까지 들어 있었기 때문이라고 설명했다. 경쟁사 앤트로픽과 같은 방식으로 비교하기 위해 사용한 숫자였다는 것이다.
같은 자료에서 오픈AI는 3분기 전체 매출 속도가 77%, 기업 부문은 107% 늘었다고 밝혔다고 한다. 성장률과 매출 규모가 함께 등장하지만, 연 환산 매출은 실제로 지난 1년 동안 벌어들인 총액과 다른 개념이다. 최근 한 달 벌이에 12를 곱하는 식의 계산에서는 어느 시점과 누구의 몫을 넣었는지에 따라 결과가 크게 달라질 수 있다. 같은 회사에 500억과 680억이라는 숫자가 붙었다면 그 차이부터 읽어야 한다.
미국 시간 8일 시장에서는 엔비디아가 3%, 오라클이 6% 가까이, 코어위브가 8% 가까이 내렸다. AMD와 브로드컴은 4%, 인텔은 5% 하락했다. CNBC 보도는 AI 회사에 칩과 데이터센터를 파는 기업들의 주가가 실제 벌이에 대한 기대와 이어져 있음을 보여 준다. CNBC는 오픈AI가 2027년 상장을 내다보고 있고 앤트로픽도 상장을 준비 중이라고 덧붙였다.
AI 기업의 성장 기사를 읽을 때 연 환산인지 실제 1년치인지, 협력사 몫까지 들어 있는지를 확인하면 큰 숫자에 먼저 흔들리지 않을 수 있다. 여기서 주가 움직임은 보도의 맥락을 보여 주는 정보이지 투자 판단의 근거로 제시하는 것은 아니다.
바이오허브의 18억 달러는 새 돈만의 합계가 아니다
생명과학 데이터 사업에서도 합산 방식이 중요했다. 비영리 연구기관 바이오허브는 미국 시간 7일 에너지부 DOE·국립보건원 NIH·새 후원사들과 함께 AI가 학습할 생물학 데이터를 만들고 공개하는 사업을 확대한다고 발표했다. 자금뿐 아니라 데이터와 계산 자원까지 합친 규모는 18억 달러다. 바이오허브는 이 분야에서 가장 큰 공동 약속이라고 소개했다.
발표에 따르면 에너지부는 5년 동안 5억 달러 넘게, 구글 딥마인드·아이소모픽 랩스·메타는 합쳐 3억 달러를 보탠다. 바이오허브 몫은 앞서 약속한 5억 달러이며 엔비디아는 계산 장비와 기술을 지원한다. 이 가운데 국립보건원 몫은 새로 투입되는 현금이 아니다. 이미 5억 달러 넘게 들여 만든 데이터와 저장소를 AI 학습에 맞춰 표준화하고 연결하는 일이다.
따라서 18억 달러 전부가 새 돈으로 들어온다고 읽으면 사업의 성격이 달라진다. 기존 데이터와 자원도 중요한 기여지만 새로운 지출과는 구분해야 한다. 목표는 가상 세포다. 실험실에서 진행하던 실험 일부를 컴퓨터 안에서 먼저 해 볼 수 있는 예측 모델을 만들려는 것이다.
일반 이용자가 당장 할 일은 없지만, 앞으로 AI가 신약 개발 기간을 줄였다는 소식을 이해하는 배경은 된다. 눈에 띄는 모델 발표 뒤에는 학습에 쓸 데이터를 만들고 공개하는 작업이 있다. 새로운 약속과 기존 자원을 함께 쓰는 이번 사업도 그 밑바탕을 넓히려는 시도다.
AI에게 설명서를 더 준다고 항상 나아지지는 않았다
데이터를 늘리는 사업과 달리 지침을 추가하는 효과는 별도로 확인해야 한다. AI 에이전트의 스킬은 작업 순서와 참고 자료를 묶은 작은 설명서다. 이번 주 arXiv에 올라온 연구 「An Empirical Study of Agent Skills’ Downstream Utility」는 87개 과제로 스킬의 실제 효과를 시험했다. 같은 과제를 스킬 없이 풀 때와 스킬을 주고 풀 때의 통과율을 아홉 가지 모델·실행 환경 조합에서 비교했다.
과제의 36.78%에서는 같은 스킬이 어떤 조합에 도움이 되지만 다른 조합에는 오히려 해가 됐다. 연구진은 권장 절차가 실행에 짐이 되는 사례를 기록으로 보여 줬다. 내용이 관련 있어 보이는 순서대로 선택하면 더 유용한 후보를 놓치는 경우도 있었다. 과제에 필요한 작업을 얼마나 받쳐 주는지를 기준으로 다시 고르자 첫 선택의 통과율이 4.35~5.80%포인트 올랐다.
관련성이 있어 보인다는 것과 실제 결과를 개선한다는 것은 다른 판단이다. 챗봇에 긴 지침을 붙여 사용하는 경우에도 많이, 자세히 쓰는 것만으로 효과를 장담하기 어렵다. 지침을 넣기 전후에 같은 질문을 던져 결과를 비교하면 내 작업에서 도움이 되는지를 확인할 수 있다. 절차를 더하는 일이 오히려 부담이 될 수 있다는 연구 결과는 그 비교가 필요한 이유다.
가짜 정보는 글뿐 아니라 간판도 만든다
AI 결과를 확인하는 문제는 도구 사용을 넘어 정보를 읽는 일에도 이어진다. 오픈AI는 미국 시간 8일 「Disrupting AI-enabled “false front” operations」 보고를 발표했다. 오픈AI 소식 목록의 요약에 따르면 AI를 사용한 영향력 공작 두 건을 막았으며, 이들은 가짜 기자와 가짜 싱크탱크를 앞세워 국제 정세에 대한 메시지를 퍼뜨렸다.
보고서 원문은 이 글을 쓰는 동안 열리지 않았다. 따라서 어느 나라와 관련됐는지, 계정 수가 얼마인지 같은 세부는 확인한 내용으로 적을 수 없다. 요약에서 드러나는 핵심은 가짜 기사 한 편만이 문제가 아니라는 점이다. 연구소처럼 보이는 기관과 경력이 그럴듯한 기자라는 간판 자체가 만들어질 수 있다.
처음 보는 연구소나 기자의 주장이 크게 퍼질 때는 그 이름으로 다른 곳에 남은 기록이 있는지 찾아볼 만하다. 그럴듯한 문장만 검토해서는 그 문장이 빌리고 있는 권위를 놓칠 수 있다. 앞의 매출과 기부 규모에서 숫자의 구성을 확인했듯, 여기서는 주장하는 사람과 기관의 바탕을 확인해야 한다.
업데이트가 바꾼 것은 기능보다 멈추는 방식이었다
어제 나온 작업 도구 업데이트에도 눈에 덜 띄는 변화가 있다. 깃허브 릴리스 노트에 따르면 클로드 코드 2.1.295는 AI의 행동 전에 검사하는 훅에 onFailure: block 설정을 추가했다. 이전에는 검사 프로그램이 시작하지 못하거나 시간이 지나 멈췄을 때 행동이 통과할 수 있었다. 새 설정을 켜면 그런 경우 행동을 차단한다. 검사가 실패했을 때 문을 열 것인지 잠글 것인지의 차이다.
오픈AI 코덱스 0.162.0은 파일 편집 때 윈도우식 줄바꿈 CRLF를 별도 설정 없이 보존하도록 고쳤다. 서버가 기다렸다 다시 요청하라고 알려 주면 그 시간을 따르는 변경도 들어갔다. 누스 리서치의 헤르메스 에이전트 0.21.6은 새 안정 배포 절차로 낸 첫 판이며 대시보드 로그인 관련 보안 문제 네 가지를 수정했다. 테너블 리서치가 알린 문제 가운데는 로그인 코드가 엉뚱한 주소로 보내져 세션을 빼앗길 수 있던 경우도 있었다.
이런 업데이트는 새 기능을 구경하는 일보다 안전하게 사용을 이어 가는 데 가깝다. 휴대폰이나 AI 도구의 변경 목록에 보안 수정이 적혀 있다면 미루지 않는 것이 쉬운 방어다. 기능 소개가 길어도 보안 항목을 함께 읽어야 하는 이유다.
이날 AI 뉴스는 첫인상을 확인하는 여러 방법을 남겼다. 매출과 지원 규모는 무엇을 합쳤는지 살피고, 지침의 효과는 실제 비교로 확인하며, 퍼지는 주장은 그 뒤의 기관과 사람까지 들여다봐야 한다. 도구에서는 새 기능뿐 아니라 실패했을 때 멈추는 방식도 중요했다. 그럴듯하다는 느낌을 사실로 바꾸기 전에 한 번 더 확인하는 일이, 큰 발표와 작은 수정 모두를 제대로 읽게 한다.
Leave a Reply